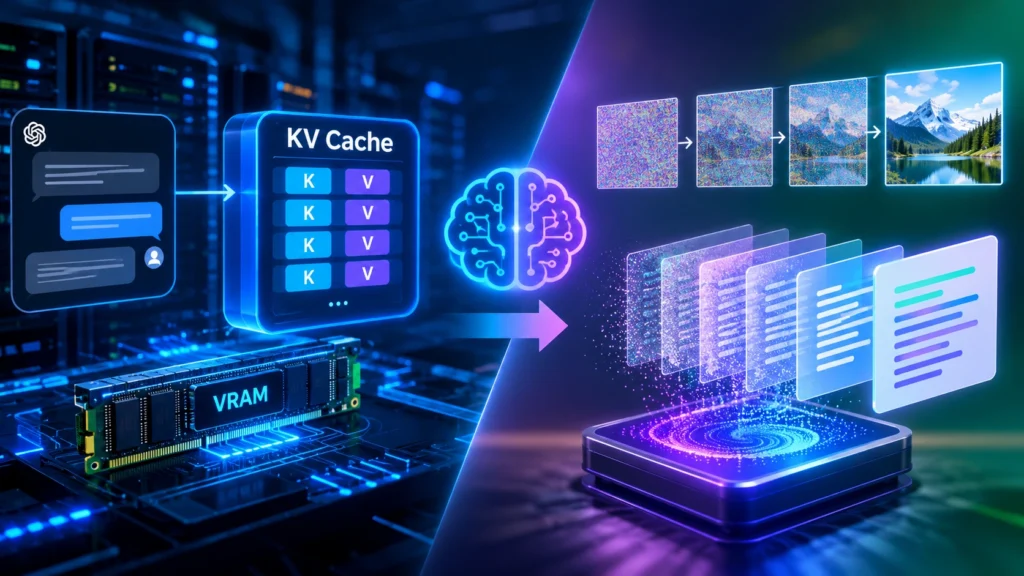
AI mein KV Cache: Agar aap ChatGPT, Claude ya Gemini jaise AI chatbots use karte hain, to shayad kabhi socha hoga ki AI aapki purani baatein itni jaldi kaise yaad rakhta hai. Aisa nahi hai ki AI insan ki tarah sab kuch permanently yaad rakhta hai. Iske peeche ek smart system kaam karta hai jise KV Cache (Key-Value Cache) kaha jata hai.
Filhal lagbhag sabhi bade Language Models isi technique par depend karte hain. Lekin jaise-jaise AI models aur conversations badi hoti ja rahi hain, KV Cache ek badi memory problem ban raha hai. Isi wajah se researchers ab Diffusion LLM Technology par kaam kar rahe hain, jo future me AI ko aur fast aur efficient bana sakti hai.
Aaiye ise simple Hinglish me samajhte hain.
KV Cache Kya Hai?
Jab aap AI ko koi prompt bhejte hain, to woh us prompt ko chhote-chhote parts me todta hai. Inhe tokens kaha jata hai.
Maan lijiye aapne AI se pucha:
“Mujhe AI ke baare me detail me batao.”
Ab jab AI jawab likhne lagta hai, to har naya token likhte waqt use pichhle tokens ka context samajhna padta hai.
Agar AI har baar pura prompt dobara process kare, to response bahut slow ho jayega. Isi problem ko solve karne ke liye KV Cache use hota hai.
KV Cache Kaise Kaam Karta Hai?
Transformer model har token ke liye do important mathematical representations banata hai.
- Key: Yeh batata hai ki token kis context se related hai.
- Value: Yeh us token ki useful information store karta hai.
Ek baar yeh values calculate ho jati hain, to AI unhe memory me save kar leta hai. Agli baar wahi calculations dobara karne ki zarurat nahi padti.
Isse response kaafi fast ho jata hai.
KV Cache Itna Important Kyun Hai?
Agar KV Cache na ho, to har naya word generate karne ke liye AI ko shuru se sari calculations repeat karni padengi.
Iske fayde hain:
- Fast response generation
- Kam repeated calculations
- Better conversation continuity
- Real-time chatting possible
Isi wajah se ChatGPT jaise systems natural speed me reply de pate hain.
KV Cache Ki Sabse Badi Problem
Yahan se asli challenge shuru hota hai.
Jaise-jaise conversation lambi hoti hai, KV Cache bhi bada hota chala jata hai. Har token ka Key aur Value memory me store rehta hai.
Iska seedha asar GPU ki VRAM aur RAM par padta hai.
Isi problem ko experts Memory Wall kehte hain.
Iska Kya Nuksan Hota Hai?
- GPU memory jaldi bhar jati hai.
- Server chalane ka kharcha badhta hai.
- Long chats me performance slow ho sakti hai.
- Ek saath kam users ko handle kiya ja sakta hai.
Isi wajah se AI companies naye solutions dhoond rahi hain.
Diffusion LLM Technology Kya Hai?
Ab baat karte hain us technology ki jo future me KV Cache ka alternative ban sakti hai.
Aaj ke LLMs Autoregressive method use karte hain.
Iska matlab hai ki AI ek baar me sirf agla token predict karta hai.
Jaise:
- Pehle pehla word.
- Fir doosra.
- Fir teesra.
Ye process bahut accurate hota hai, lekin lambi generation me expensive ho jata hai.
Diffusion Approach Kaise Alag Hai?
Agar aapne DALL·E ya Midjourney ke baare me suna hai, to Diffusion ka basic idea samajhna aasaan hai.
Image Diffusion Models pehle random noise se shuru karte hain.
Uske baad dheere-dheere us noise ko clean karke final image banate hain.
Text ke liye bhi isi concept ko adapt kiya ja raha hai.
Isse Diffusion LLM kaha jata hai.
Diffusion LLM KV Cache Ko Kaise Badal Sakta Hai?
Yeh sabse interesting hissa hai.
Traditional LLM har token ke liye KV Cache banata hai.
Lekin Diffusion LLM ka target hota hai ki woh text ke bade hisson ko ek saath refine kare.
Iske kuch possible fayde hain.
1. Ek Saath Bada Text Generate Karna
Word-by-word likhne ke bajay model ek paragraph ya text block ko ek saath improve kar sakta hai.
2. Kam Memory Ki Zarurat
Kyuki traditional KV Cache par dependency kam ho sakti hai, GPU memory ka pressure bhi kam ho sakta hai.
3. Large Documents Handle Karna
Future me books, research papers aur bade coding projects ko efficiently process karna aasaan ho sakta hai.
Yeh abhi research ka active area hai, lekin direction kaafi promising dikh rahi hai.
Kya Diffusion LLM Kal Hi Sab Kuch Replace Kar Dega?
Short answer hai: Nahi.
Abhi bhi is technology ke saamne kai challenges hain.
Sabse Bade Challenges
- Grammar ko perfectly maintain karna.
- Sentence ka exact meaning preserve karna.
- Human-level coherence banana.
- Long text me logical consistency rakhna.
Isiliye researchers abhi is par kaafi experiments kar rahe hain.
Future Me Hybrid AI Models Aa Sakte Hain
Experts ka maanna hai ki future me dono technologies saath me kaam kar sakti hain.
Example ke liye:
| Kaam | Technology |
|---|---|
| Normal Chat | Traditional Autoregressive LLM |
| Large Documents | Diffusion LLM |
| Coding Projects | Hybrid System |
| Research Writing | Hybrid System |
Is approach se speed aur memory dono ka balance mil sakta hai.
AI Ke Future Ke Liye Iska Kya Matlab Hai?
Agar Diffusion LLM successful hota hai, to AI industry me kaafi bade changes dekhne ko mil sakte hain.
Possible benefits:
- Faster AI responses
- Kam GPU memory usage
- Sasta AI infrastructure
- Better large-context processing
- Efficient enterprise AI systems
Halaanki KV Cache abhi bhi modern AI ka important hissa hai, lekin future me iska role badal sakta hai.
Conclusion
AI mein KV Cache Kya Hai iska jawab simple hai. Yeh ek smart memory system hai jo AI ko purani calculations dobara kiye bina fast response dene me madad karta hai.
Lekin iski sabse badi limitation memory usage hai.
Isi problem ko solve karne ke liye Diffusion LLM Technology par research chal rahi hai. Yeh technology abhi development phase me hai, lekin future me AI ko aur fast, efficient aur scalable bana sakti hai.
Aane wale kuch saalon me shayad hum aise Hybrid AI Models dekhen jo KV Cache aur Diffusion dono ka best combination use karen.
Yeh format direct Copy karke WordPress me paste kar sakte ho. Headings, divider line (---), bullet points aur table bhi sahi format me paste honge.
Also Read This
- Diffusion LLM Kya Hai? AI Ka Naya Tarika Jo Ek Sath Puri Tasveer Dekhkar Jawab Banata Hai
- HUAWEI Watch GT 7 and GT 7 Pro: 21 Days Battery, Dual-Band GPS aur Premium Design, Kya Wait Karna Chahiye?
- 1 Saal Mein 1000 Se 1 Crore Kaise Banaen? Sach, Strategy Aur Real Roadmap
- iPhone 17 Pro Kitne Din Ki Mehnat Ke Baad Khareed Sakte Hain? Global Reality Check 2026
- Nvidia’s $3.5 Billion AI Bet: Future of Chips Ka Naya Yug Shuru?